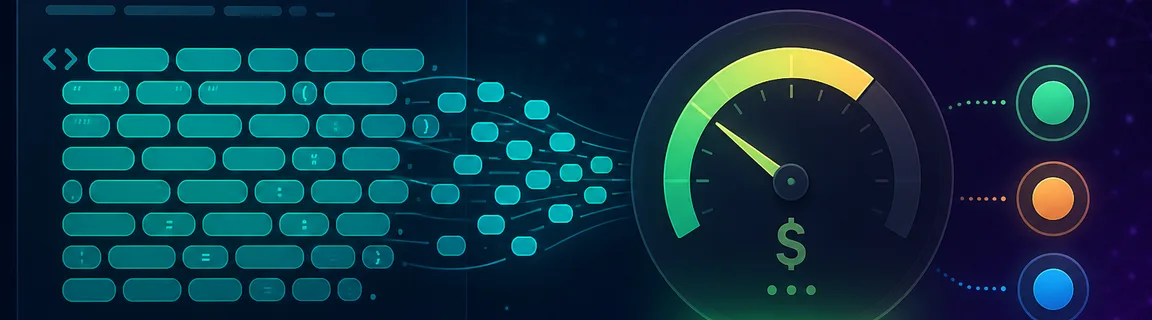
LLM-Tokens zählen und API-Kosten lokal schätzen (OpenAI, Claude, Gemini)
Vor dem LLM-API-Aufruf: Tokens zählen, USD-Kosten schätzen und Kontextfenster prüfen — 100 % im Browser, ohne Ihren Prompt zu senden.
Warum Tokens zählen, bevor Sie eine LLM-API aufrufen?
Jede Anfrage an OpenAI, Anthropic oder Google wird in Eingabe-Tokens und Ausgabe-Tokens abgerechnet — nicht in Wörtern oder Zeichen. Ein langer System-Prompt, Few-Shot-Beispiele oder Multi-Turn-Historie verbrauchen das Kontextfenster-Budget bevor Ihre Nutzerfrage. Ohne Vorabmessung treffen Sie auf Truncation-Fehler oder eine überraschende Rechnung am Monatsende. Auf FastMinify laufen der LLM-Token-Zähler, der LLM-Preisrechner und der Context-Window-Rechner vollständig im Browser — Ihr Text verlässt das Gerät nie. Entdecken Sie den KI- & LLM-Tools-Hub für den kompletten Workflow.
Ehrliche Grenzen und Best Practices
FastMinify zielt auf schnelle Browser-Planung — nicht auf Buchhaltungsabgleich oder Runtime-Optimierung.
Zählen zeigt oft offensichtliches Fett in System-Prompts und doppeltem Kontext.
Anders als viele Online-Zähler, die Text an einen Server senden, tokenisiert FastMinify lokal. Nützlich für Prompts mit proprietärem Code, PII oder internen Specs.
Tokens, tiktoken und Heuristiken: was Sie wirklich messen
Ein Token kann ein ganzes Wort, eine Silbe, Satzzeichen oder ein Fragment sein. „Entwicklung“ kann je nach Modell mehrere Tokens sein; „API“ oft nur eines. Deshalb ersetzt ein Wortzähler keinen Token-Zähler für LLM-Abrechnung.
FastMinify lädt js-tiktoken bei Bedarf für OpenAI-Modelle (o200k_base oder cl100k_base) und zeigt das Badge Exact. Für Claude und Gemini veröffentlichen Anthropic und Google keinen Browser-Tokenizer — wir wenden eine Zeichen-pro-Token-Heuristik an (typisch ±5–15 %) mit dem Badge Estimate.
[{"role","content"}]-Array mit ChatML-OverheadKosten hängen von beiden Richtungen ab: Prompt (Input) und Completion (Output). Das Kontextfenster begrenzt Input + reserviertes Output — der Context-Window-Rechner zieht eine Output-Reserve ab (Standard 15 %), um das effektive Input-Budget zu schätzen.
Drei-Tool-Workflow: zählen, schätzen, Fenster prüfen
Fügen Sie Ihren Prompt oder ein JSON-Messages-Array in den LLM-Token-Zähler ein. Max 512 KiB UTF-8. Compare all models für Zähler über das gesamte Registry.
Übertragen Sie Input/Output-Token-Zähler in den LLM-Preisrechner, oder fügen Sie den Prompt ein, um Input-Tokens über dieselbe countTokensAsync-Pipeline abzuleiten. Tarife stammen aus einer manuell geprüften llm-models.json-Tabelle — Verified-Datum auf dem Tool.
Der Context-Window-Rechner nutzt dieselbe Zählpipeline und vergleicht Ihren Prompt mit dem effektiven Budget (Fenster − Output-Reserve). Ideal vor Multi-Turn-Agenten oder großen RAG-Pastes.
Sie bauen System-Prompt + 20 Vektor-Chunks + Nutzerfrage für GPT-4o.
Vollen Kontext zählen
Alles (oder das Messages-Array) in den Token-Zähler einfügen. Input-Tokens am Zielmodell notieren und Exact- vs Estimate-Badge prüfen.
Kontext-Marge testen
Context-Window-Rechner mit dem gleichen Text öffnen. Bei Near limit oder Won't fit Chunks kürzen oder Modell mit größerem Fenster wählen.
Monatskosten projizieren
Im Preisrechner Input-Tokens eingeben, Output-Tokens schätzen (z. B. 500), Caching aktivieren wenn System-Prompt stabil, dann mit erwarteten Aufrufen/Tag multiplizieren.
Fazit
Tokens vor dem API-Aufruf zu zählen vermeidet Truncation- und Abrechnungsüberraschungen. Nutzen Sie den LLM-Token-Zähler für eine ehrliche Aufschlüsselung (Exact für OpenAI, Estimate sonst), den Context-Window-Rechner für RAG- oder Multi-Turn-Marge, dann den Preisrechner für USD-Projektion — alles im Browser, ohne Ihren Prompt an Provider zu senden.
Tokens zählen und Kosten jetzt schätzen
Verwandte Artikel
Netzwerk, Maske, Hostbereich und Broadcast eines CIDR berechnen, Bereiche zu minimalen Blöcken zusammenfassen und IPs prüfen, direkt im Browser.
cURL-Kopien formatieren, rohe HTTP-Anfragen und -Antworten parsen und HAR-Exporte lesen, direkt im Browser: nichts wird gesendet oder wiederholt.
Header und Payload eines JWT dekodieren oder ein Test-Token signieren, direkt im Browser: HS256, RS256, ES256, ohne Secret an einen Drittserver zu senden.