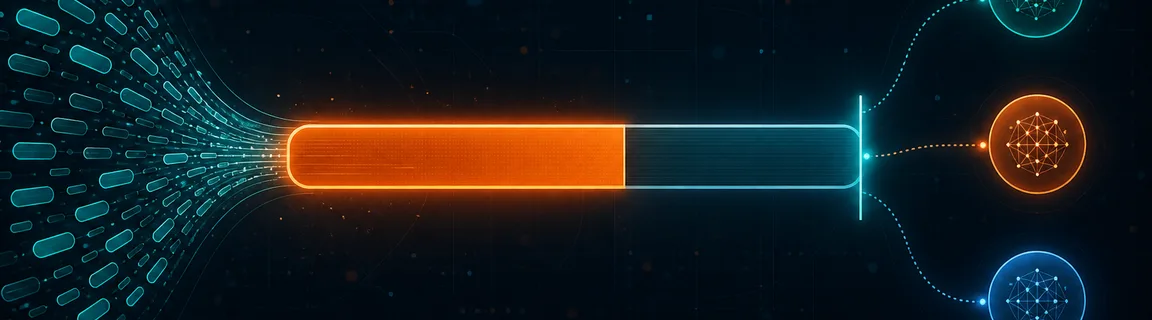
LLM-Kontextfenster: Prompts für GPT, Claude und Gemini dimensionieren
RAG, Multi-Turn-Agenten, System-Prompts: Kontextfenster-Auslastung und verbleibende Reserve vor dem API-Aufruf berechnen.
Warum Prompts vor dem API-Aufruf dimensionieren?
Das Kontextfenster eines LLM begrenzt, wie viele Tokens Sie in einer Anfrage senden und empfangen können. Ein langer System-Prompt, zwanzig RAG-Chunks, Multi-Turn-Verlauf und die erwartete Antwort teilen sich dasselbe Budget — keine getrennten Kontingente. Überschreiten Sie das Limit, erhalten Sie einen 400-Fehler; liegen Sie an der Grenze, kann das Modell den Anfang oder das Ende des Kontexts abschneiden, ohne explizite Warnung. Auf FastMinify misst der Kontextfenster-Rechner Ihren Prompt gegen die GPT-, Claude- und Gemini-Modellliste — 100 % im Browser. Ergänzen Sie mit dem LLM-Token-Zähler und JSON-Formatierer für API-Message-Payloads. Siehe auch den Leitfaden LLM-Tokens zählen und API-Kosten schätzen und den KI- & LLM-Tools-Hub.
Häufige Fehler: Überlauf, Truncation und falsche Anzeige
Ein „128k“-Modell bietet nicht 128k Input-Tokens, wenn Sie 8k Tokens Antwort erwarten. Ohne Output-Reserve glauben Sie zu passen, während die Generierung abgeschnitten wird.
Merken — 15–20 % Output-Reserve im Kontextfenster-Rechner setzen, bevor Sie einen großen RAG-Paste validieren.
Manche Pipelines schneiden Anfang (System-Prompt) oder Ende (aktuelle Chunks) ab, wenn der Kontext das Limit überschreitet — ohne HTTP-Fehler. Das Modell antwortet trotzdem auf unvollständigem Kontext.
Merken — Safe (< 80 % des effektiven Budgets) für kritische RAG-Workflows anstreben; Near limit braucht Reduktionspuffer.
Wörter- oder Zeichenzähler spiegeln weder Abrechnung noch Fensterlimit wider. Code, JSON und nicht-lateinischer Text weichen stark vom Wort/Token-Verhältnis ab.
Merken — LLM-Token-Zähler am Zielmodell — Exact-Badge für OpenAI, Estimate für Claude/Gemini.
Zehn kurze Messages plus Tool-Definitionen können Hunderte Tokens mehr kosten als gleichwertiger Klartext. JSON-Parse-Fehler verbergen auch fehlende Keys.
Merken — Messages-Payload mit json-formatter formatieren, dann API-messages-Modus im Rechner.
Ehrliche Grenzen und Best Practices
FastMinify hilft, das Kontextbudget im Browser zu planen — nicht das exakte Provider-Runtime-Verhalten zu simulieren.
Zählen zeigt oft vermeidbaren Ballast in System-Prompts und doppeltem Kontext.
Zählen ist 100 % clientseitig — geeignet für Prompts mit proprietärem Code, PII oder internen Specs.
Kontextfenster vs. Tokens: was wirklich zählt
Anbieter werben mit Token-Limits (z. B. 128k, 200k, 1M) — nicht mit Wörtern oder Zeichen. Ein Token kann ein ganzes Wort, ein Fragment oder Satzzeichen sein. Der LLM-Token-Zähler nutzt js-tiktoken (Exact-Badge) für OpenAI und eine Zeichen/Token-Heuristik (Estimate-Badge, ±5–15 %) für Claude und Gemini.
Der Kontextfenster-Rechner zieht eine konfigurierbare Output-Reserve ab (10 %, 15 % oder 20 % — Standard 15 %), bevor das effektive Input-Budget berechnet wird. Nutzt Ihr Prompt 85 % dieses Budgets, sind Sie Near limit, auch wenn das Rohfenster noch Reserve zeigt.
Im Modus API messages fügt ein [{"role","content"}]-Array ChatML-Overhead hinzu (+3 Tokens pro Message, +1 pro name, +3 Response-Priming). Struktur mit dem JSON-Formatierer prüfen, bevor Sie in den Rechner einfügen. Bei RAG den injizierten Kontext zusätzlich zur Nutzerfrage zählen — nicht nur die finale Frage.
Workflow: Kontextrechner, Token-Zähler und JSON-Messages
Öffnen Sie den Kontextfenster-Rechner. Fügen Sie Klartext oder ein Messages-JSON-Array ein. Wählen Sie Modell, Output-Reserve (10 / 15 / 20 %) und Encoding (Auto oder o200k_base / cl100k_base Override). Compare all models listet Nutzung %, verbleibende Tokens und Verdict pro Modell.
Für BPE-Detail (OpenAI Exact) oder Input-Tokens vor der Preisberechnung den LLM-Token-Zähler mit demselben Text öffnen. Beide Tools teilen die countTokensAsync-Pipeline — Summen sollten bei gleichem Modell und Format übereinstimmen.
Chat-Completions-Integrationen senden oft ein messages-JSON. In den JSON-Formatierer einfügen, um Trailing Commas, ungültige Anführungszeichen oder falsche Struktur zu finden — dann formatiertes JSON im API-messages-Modus im Kontextrechner laden.
Sie injizieren 40 Vektor-Chunks + System-Prompt + 6 Verlaufs-Runden für Claude Sonnet.
Vollständigen Kontext zusammenstellen
System + Chunks + Verlauf + Frage in den Rechner (oder äquivalentes Messages-Array) einfügen. Ziel-Anthropic-Modell wählen und 20 % Reserve, wenn Antworten oft 4k Tokens überschreiten.
Verdict und Reserve lesen
Bei Won't fit: Chunks kürzen (niedrigeres top-k), Verlauf zusammenfassen oder per Compare all models auf größeres Fenster wechseln. Bei Near limit: Truncation oder Request-Splitting planen.
Messages-JSON validieren
Finalen Payload in json-formatter formatieren, im API-messages-Modus neu zählen, dann mit dem Token- und API-Kosten-Leitfaden USD projizieren.
Fazit
Einen Prompt zu dimensionieren heißt: Output-Reserve abziehen, Tokens am richtigen Modell zählen und das Verdict vor dem API-Aufruf lesen. FastMinifys Kontextfenster-Rechner kombiniert Multi-Provider-Liste, konfigurierbare Reserve und Safe / Near limit / Won't fit — alles lokal. Ergänzen Sie mit Token-Zähler für Details und json-formatter für Message-Payloads; Token- & Kosten-Leitfaden und KI-Hub decken den restlichen Workflow ab.
Prüfen Sie, ob Ihr Prompt ins Kontextfenster passt
Verwandte Artikel
Netzwerk, Maske, Hostbereich und Broadcast eines CIDR berechnen, Bereiche zu minimalen Blöcken zusammenfassen und IPs prüfen, direkt im Browser.
cURL-Kopien formatieren, rohe HTTP-Anfragen und -Antworten parsen und HAR-Exporte lesen, direkt im Browser: nichts wird gesendet oder wiederholt.
Header und Payload eines JWT dekodieren oder ein Test-Token signieren, direkt im Browser: HS256, RS256, ES256, ohne Secret an einen Drittserver zu senden.